
ComfyUI-Sa2VA
Sa2VA-8B 的 ComfyUI 插件:图像 / 视频反推提示词,并在同一次推理里拿到 grounded 分割掩码。
ComfyUI-Sa2VA
Sa2VA-8B 的 ComfyUI 插件:图像 / 视频反推提示词,并在同一次推理里拿到 grounded 分割掩码。
模型在本插件目录内 vendored(sa2va/),配置与 tokenizer 随插件分发(assets/),不依赖 HuggingFace 上的 remote code,也不联网。
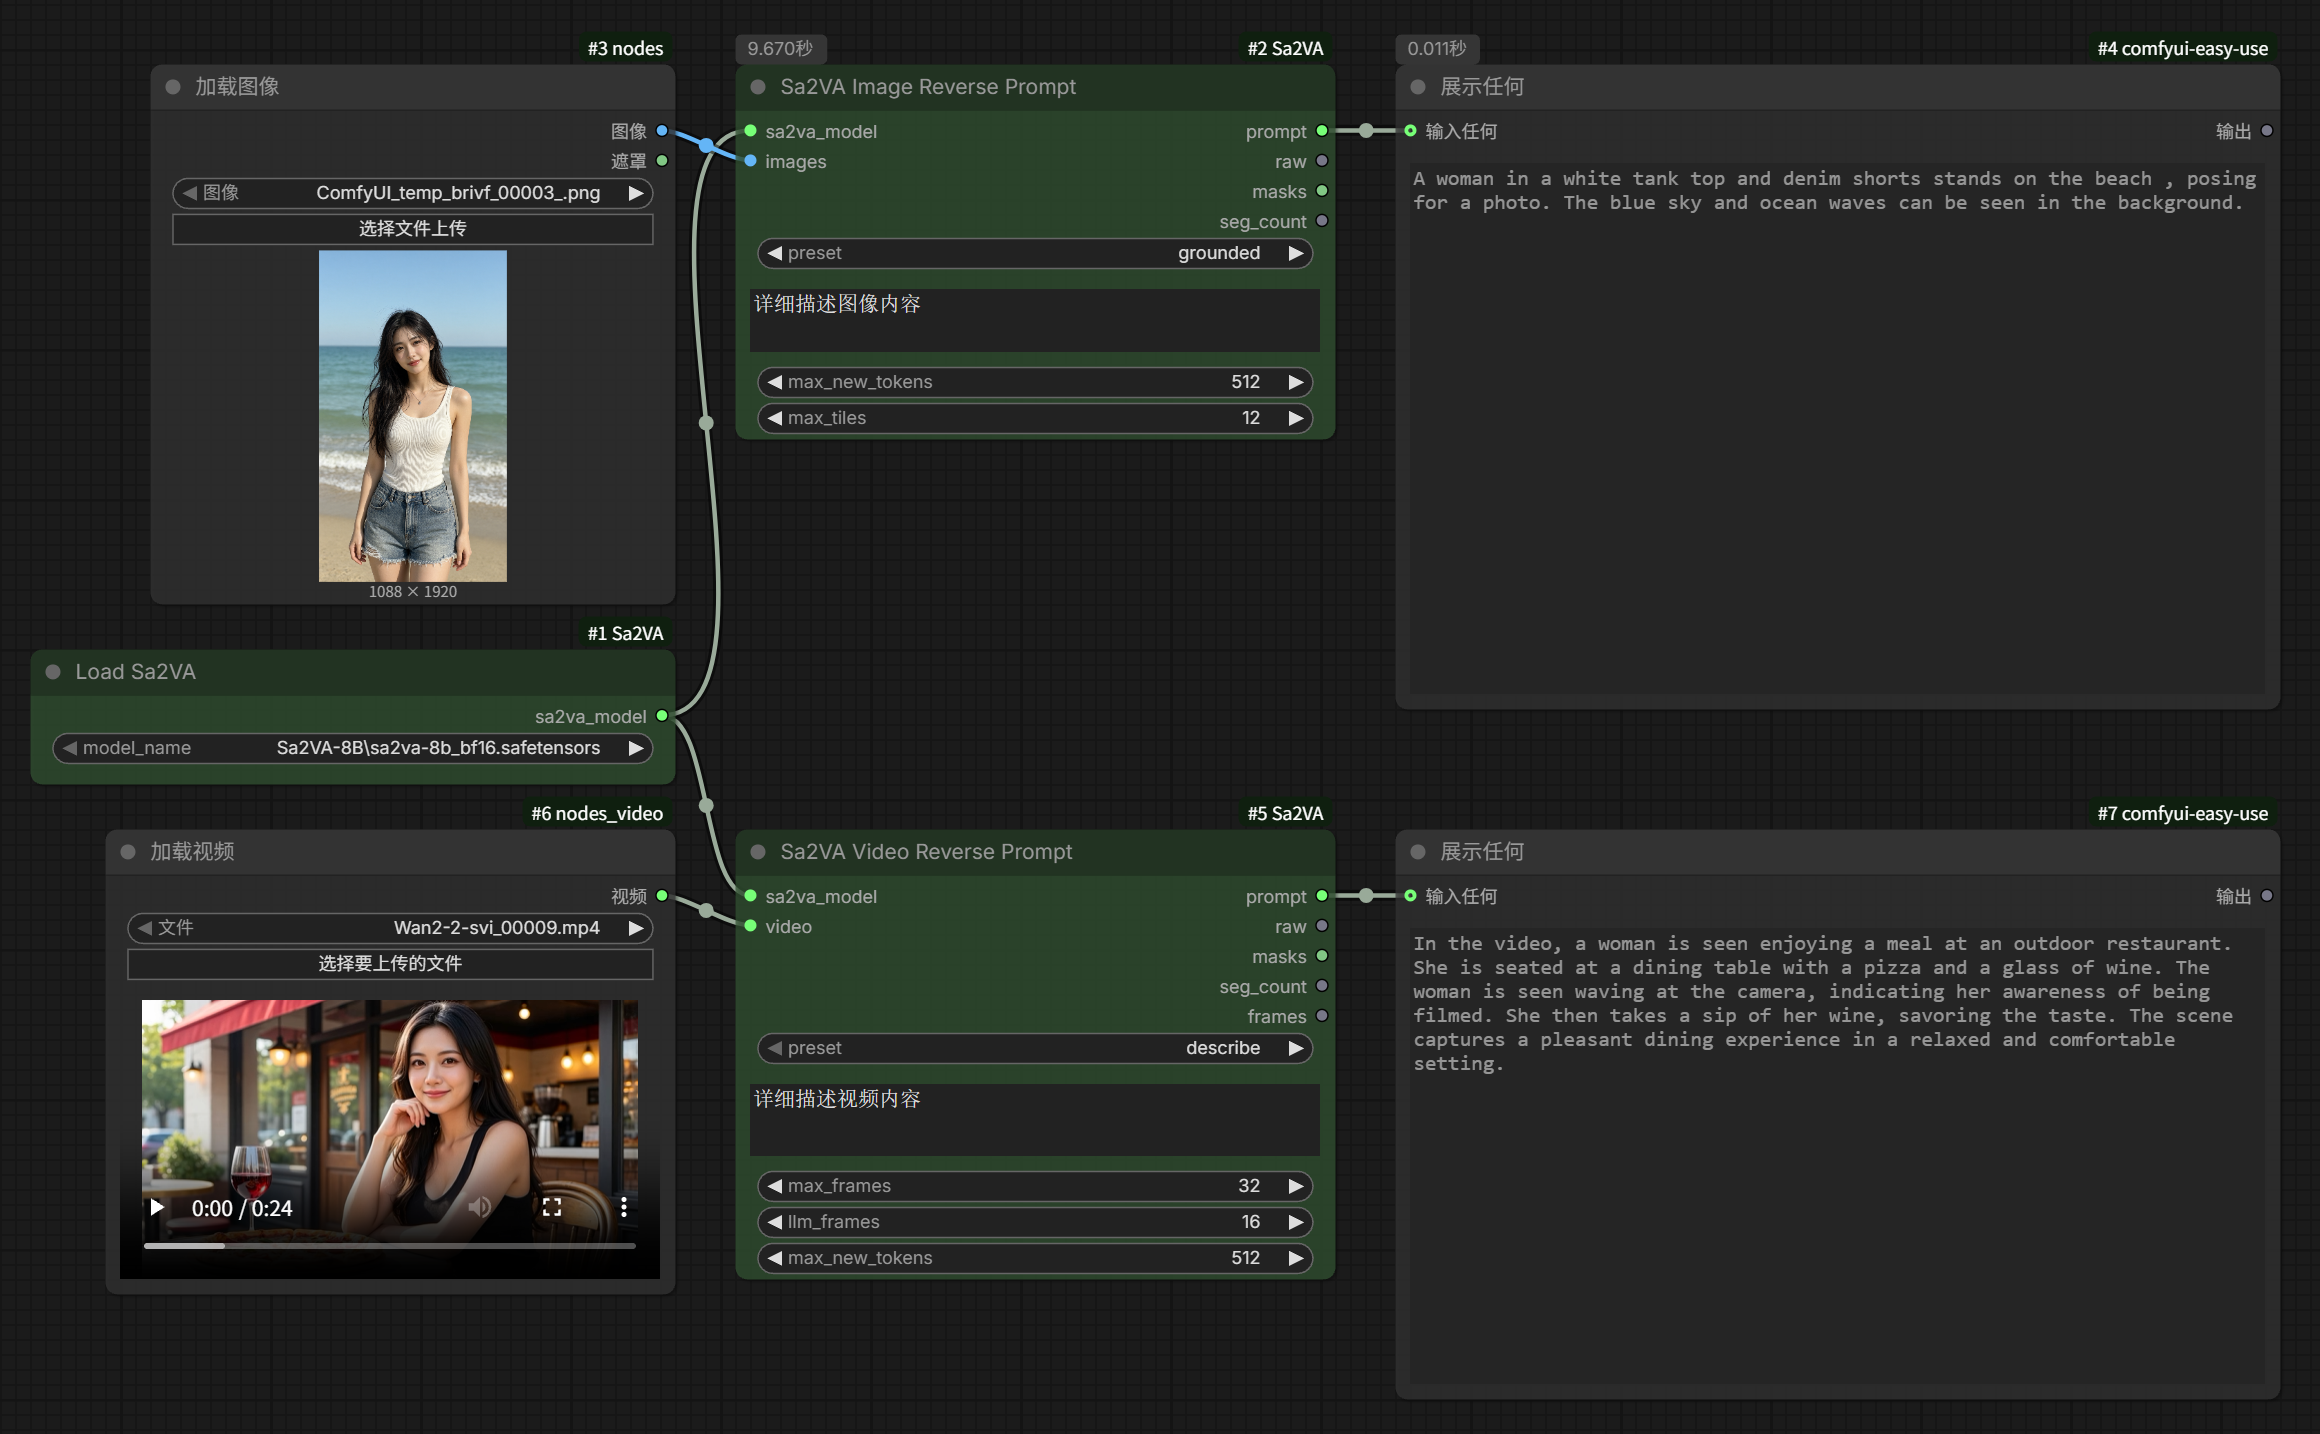
工作流直达:示例工作流
节点
| 节点 | 说明 |
| --- | --- |
| Load Sa2VA | 从 models/sa2va 读取单文件权重,输出 SA2VA_MODEL |
| Sa2VA Image Reverse Prompt | 图像 → 文字(正片叠底的 grounded 掩码随文字一起出) |
| Sa2VA Video Reverse Prompt | 视频 → 文字 + 逐帧掩码 |
输入
presetdescribe:官方Please describe the image./Please describe the video.,只要文字grounded:官方 interleaved segmentation 提问,文字里的每个部位对应一张掩码sd_prompt:要求模型写一条可直接复现的绘图提示词(实验性,模型未针对此任务训练)custom:custom_prompt原样送模型。需要<image>占位符时可在里面自己写(不写会被自动补在开头)
max_tiles(图像):视觉编码器动态切块上限,默认 12;越大越清晰、越慢、越吃显存max_frames/llm_frames(视频):max_frames是抽帧数(同时是 SAM2 传播的帧数),llm_frames是其中真正送进语言模型的帧数,其余帧由 SAM2 跟踪
输出
prompt:去掉<...>标签与[SEG]标记后的干净文字,可直接连到 CLIP Text Encoderaw:模型原始输出(含标签),排查问题时用masks:float32、值域 0/1、尺寸等于输入图像(视频为抽帧后的原始尺寸)- 图像:
(seg_count, H, W) - 视频:
(seg_count * frames, H, W),对象优先——第i个对象、第f帧在i * frames + f
- 图像:
seg_count:掩码对象数;describe/sd_prompt下为 0,masks是空张量frames(仅视频):实际抽帧数
安装
cd ComfyUI/custom_nodes
git clone <this repo> ComfyUI-Sa2VA
依赖(torch、transformers、safetensors、einops)ComfyUI 已经自带,无需额外安装。
权重
插件只接受单文件验收模板,放在 ComfyUI/models/sa2va/ 下:
可通过魔搭下载:https://modelscope.cn/models/mailzwj/Sa2VA
网盘直达:https://pan.quark.cn/s/055f42cd0fe5
ComfyUI/models/sa2va/
└── Sa2VA-8B/
    └── sa2va-8b_bf16.safetensors
config.json 可选:与权重放在同一目录会被优先读取,否则用插件自带的 assets/sa2va8b_config.json(Sa2VA-8B 配置)。
从 HuggingFace 的 7 分片原始权重转换:
D:/UserApps/Conda/envs/cu130/python.exe -B tools/convert_sa2va.py \
    --src F:/Download/Sa2VA-8B --mode bf16 \
    --out-dir D:/Workspace/ComfyUI/models/sa2va/Sa2VA-8B
脚本逐张量流式读写,峰值内存与单个张量同量级,可用 --self-test 自检、--verify <file> 抽样核对。
int8 暂不支持。 tools/convert_sa2va.py --mode int8 生成的是 ComfyUI mixed_precision_ops 格式(int8_tensorwise + ConvRot),而 vendored 模型走的是普通 torch 模块,没有对应的量化算子接入点;这样加载会给出明确报错,请用 bf16 产物。
显存
- bf16 权重常驻约 16.6 GiB,实测 1024×1024 图像 grounded 推理峰值 17.7 GiB,8 帧视频 17.8 GiB
- 显存不足时由 ComfyUI 的 patcher 自动换出/换入,不会 OOM,代价是首帧耗时变长(冷启动 16.6 GB 从磁盘读入约 2 分钟,命中系统缓存后约 5 秒)
- 视频显存大头是 SAM2 逐帧传播,
max_frames是主要旋钮
已知限制
- 图像节点只取 batch 里的第一张图
- 视频节点把整段视频按
Video组件的帧序列读入内存,长视频建议先裁剪 sd_prompt是借用模型的描述能力,实测产出是一段 60 词左右的英文描述而非逗号分隔的 SD 提示词,能不能直接用要自己看- 单次推理耗时(RTX 5090,图像 1600×1600、
max_tiles=4):describe≈ 2.7 s、grounded≈ 1.4 s、sd_prompt≈ 10 s(输出更长)