
IndexTTS2-PauseControl
IndexTTS2 精确停顿控制([pause:N])ComfyUI 节点:停顿延长/缩短/插入,平均偏差 13ms,支持批量生成与试听验收。Precise pause control for IndexTTS2 — TTS ComfyUI nodes with waveform-domain pause editing, ±13ms accuracy.
Nodes (7)
Batch TTS with resumable rounds and a manifest
Don't regenerate the whole take — surgically fix one pause
IndexTTSListen
Loading IndexTTS2 without reloading it every run
The node that finally makes IndexTTS2 pause where you tell it to
Lock in the final cut and get matching subtitles in one pass
Evicting an 11.8GB TTS model before your video render
IndexTTS2-PauseControl
English: README_EN.md
这是什么
IndexTTS2 的语音合成中,停顿长短由模型自行决定且不可控——同一个逗号,不同次生成可能停顿 200ms 或 500ms,无法按需求指定。
本工具(ComfyUI 节点包)提供精确停顿控制:在文本中直接指定停顿要求:
他停下脚步[pause:800ms]深吸一口气[pause:200ms]然后推开了那扇门[pause:600ms]。
生成后,"停下脚步"后停顿 800ms,"深吸一口气"后 200ms,句号前("那扇门"后)600ms——实测平均偏差 13ms。句中、句号前后均可用同一方式指定。
模型在个别位置可能断句不稳定——应停顿处未停顿、或在无标点处出现停顿。标记不受标点限制:可在任意位置(包括无标点处)指定停顿,生成时由模型在该处产生停顿并精确调整为目标时长。
官方句间静音参数(interval_silence)默认 200ms,短于句中逗号的模型自然停顿(约 300ms)——会出现句号停顿反而比逗号短的倒挂。本项目节点默认400ms(与句号的自然停顿接近),并可对句号处写标记精确覆盖。
无需修改模型、无需重新训练,安装节点即可使用。
安装
方式一:完整包(开箱即用,推荐)
- ComfyUI-Manager 搜索安装:节点已上架官方 Comfy Registry,在 Manager 中搜索
IndexTTS2-PauseControl一键安装。⚠️ 新上架节点可能暂未进入 Manager 的搜索索引(偶尔会搜不到),搜不到时请直接采用下面的手动安装:将本仓库目录(即IndexTTS2-PauseControl/)放到 ComfyUI 的custom_nodes/下,目录名保持IndexTTS2-PauseControl(⚠️ 如已存在同名目录请先备份——覆盖会替换旧内容) - 安装依赖到 ComfyUI 的 Python 环境(见
requirements.txt) - 运行
python install.py(自动装依赖 + 检查模型目录),或手动按requirements.txt安装 - 下载 IndexTTS2 模型权重到
ComfyUI/models/index_tts/(模型来源见官方 index-tts/index-tts,权重不属于本仓库) - 重启 ComfyUI
⚠️ 请以目录方式运行(放
custom_nodes/下),不要pip install .——本项目 包名与官方indextts同名,pip 安装会覆盖官方推理包。
方式二:打补丁(已有官方 indextts 包的用户,非 ComfyUI 也可)
如果你已有官方 IndexTTS2 推理代码(官方整合包 / 官方 ComfyUI 节点 / 自建管线),只需应用本仓库 patch/ 目录下的修改——不限于 ComfyUI:
- ComfyUI 用户:打补丁后直接用本仓库节点(与方式一效果相同)
- 非 ComfyUI 用户(Gradio WebUI 整合包、自建 API 等):打补丁后,在调用
IndexTTS2.infer(...)时传入pause_mode=True即可获得[pause:N]能力 (详见patch/PATCH_GUIDE.md;WebUI 接入方式未经实际部署验证)
- 将
patch/modified/中列出的文件覆盖到你的 indextts 包对应位置 - 将
patch/new_files/中列出的文件复制到对应目录 - 调用
IndexTTS2.infer(...)时传入pause_mode=True即可(见patch/PATCH_GUIDE.md)
补丁采用「完整文件覆盖 + 补丁说明」而非 git diff——官方代码版本会漂移,覆盖文件更可靠。
快速开始
1. 写标记
在文本中想要停顿的位置,直接写 [pause:时长]:
他停下脚步[pause:800ms]深吸一口气[pause:200ms]然后推开了那扇门。
他停下来[pause:1.5s]深吸一口气。
支持的写法:[pause:600ms] / [pause:600] / [pause:1.5s] / [pause:0.8s](也兼容 [wait:]、[stop:] 前缀)。生成时标记会被替换成普通逗号送入模型,不会读出"pause"之类的字。
2. 生成
ComfyUI 中连好工作流(示例见 workflows/):
IndexTTSLoader → IndexTTSSingle(打开 pause_mode) → PreviewAudio
导入示例工作流后,把 spk_ref 改成你的音色参考音频路径即可。
3. 试听对比
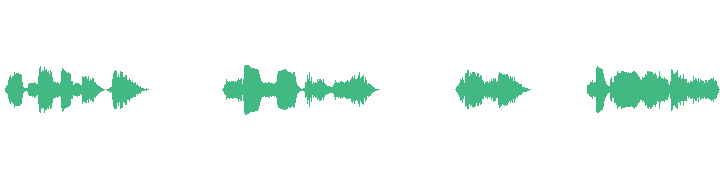
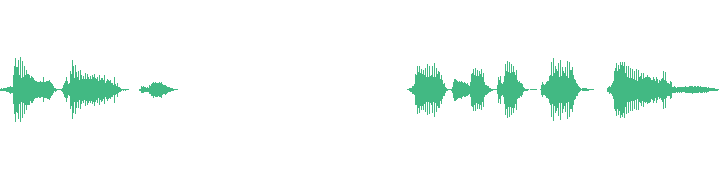
examples/audio/ 提供 4 条对比音频(同音色、同 seed,唯一差异是有没有标记):
| 文件 | 内容 | 实测停顿 |
|------|------|---------|
| zh_plain.wav | 他停下脚步,深吸一口气,然后推开了那扇门。 | 469/499/359ms(自然节奏,不规律) |
| zh_pause.wav | 他停下脚步[pause:800ms]深吸一口气[pause:200ms]… | 798ms / 190ms(精确命中) |
| en_plain.wav | He stopped and took a deep breath. | 80/309ms(自然) |
| en_pause.wav | He stopped[pause:800ms]and took a deep breath. | 798ms(精确命中) |
波形对比(点击波形图下载音频试听):
| 中文 | 英文 |
|------|------|
|  <br>zh_plain(无 pause) |
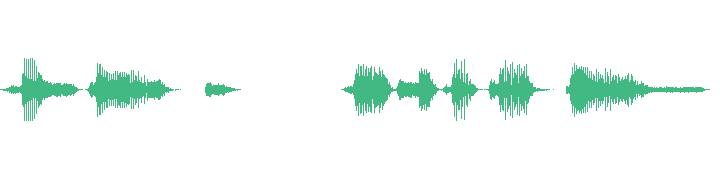 <br>en_plain(无 pause) |
|
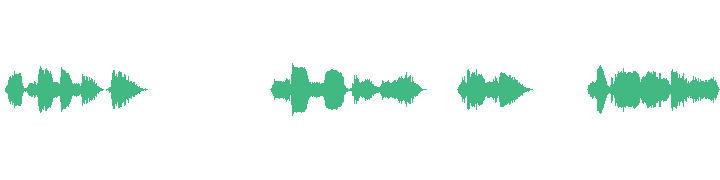 <br>zh_pause(有 pause) |
 <br>en_pause(有 pause) |
参考音色来自第三方收集音色(非本项目作者声音)。也可用examples/make_compare_demo.py 配合你自己的参考音频重新生成。
标记的更多细节
句号前后(最稳定,两种写法都精确):
他深吸一口气[pause:800ms]。然后推开了门。    ← 句号前
他深吸一口气。[pause:800ms]然后推开了门。    ← 句号后
时长范围:推荐 150ms ~ 5s(下限约 100ms;上限无硬限制,1s/2s/5s 都可以)。
中英文均可:英文句子同样精确(800ms 目标 → 实测 778ms)。
功能一览
核心能力——精确控制停顿:
- 句中停顿(逗号、顿号处):精确调整,±20ms
- 句号前后停顿:句号前、句号后两种写法都支持;即使模型在该处没有自然停顿,也会自动用"句间静音"实现目标时长——模型停不停都能达到你要的时长
- 引号场景:
句号+引号(…。')处同样可控,不用刻意避开 - 统一句号停顿:不写标记时,句号处停顿由
interval_silence统一控制(默认 400ms)。官方默认 200ms 时,段间停顿短于句中逗号的模型自然停顿(约 300ms),会出现句号停顿反而比逗号短的倒挂;400ms 与句号的自然停顿更接近,听感自然。适合先定整体节奏,再对个别句号精确覆盖
配套的生产流程能力(做长篇内容时用得上):
- 批量生成:分句稿(Markdown)或多行文本,一次跑全书;断点续跑
- 候选挑选:每段生成多轮候选(rounds),试听节点里逐轮试听
- 验收标记:听中意的候选,一键标记"第 N 轮通过"(写入 manifest,供后续拼接)
- seed 复现:固定 seed 可精确复现同一条音频;随机时自动记录实际 seed
- 字幕生成:按验收结果生成 SRT 字幕(读实际音频时长,自动对齐)
- 停顿微调:已生成的音频,按"序号"或"时间点"调整/删除某个停顿
- 显存释放:TTS 跑完、切到视频生成流程前,一键卸载模型腾显存
使用进阶
批量生成 + 候选试听 + 验收
工作流:
IndexTTSLoader → IndexTTSBatch(打开 pause_mode,rounds=3) → IndexTTSListen → PreviewAudio×3
IndexTTSBatch按分句稿(segments_md填文件路径)或text多行文本批量生成- 每段生成
rounds轮候选(如001_1.wav、001_2.wav、001_3.wav) IndexTTSListen选片段号试听 3 个候选;accept_round填 1/2/3 标记"第 N 轮通过验收"(写入 manifest.json,供后续拼接/字幕流程选用)
分句稿格式(Markdown)
segments_md 接受分句稿 Markdown 文件,格式:
---
story: 我的故事
voice_ref: references/我的音色/main.wav
emotion_base: references/译制片语气
emotions: [平静, 紧张]
speaking_speed: 1.0
max_text_tokens_per_segment: 120
---

# 片段 001 [叙述 / 平静]
<!-- 标题: 标准同样严苛 -->
标准同样严苛[pause:800ms]不多一分。

<!-- 处理后: 标准同样严苛[pause:800ms]不多一分。 -->
- YAML 头(可选):story / voice_ref / emotion_base / emotions / speaking_speed / max_text_tokens_per_segment
- 片段标题:
# 片段 N [角色 / 情绪]——情绪用于情感参考挑选("目录随机"策略) - 正文:生成文本,
[pause:N]原样保留;若提供<!-- 处理后: ... -->,以其内容为准 - 建议一句一个片段(句号停顿统一由句间静音控制,节奏规整)
- 不填分句稿时,直接在
text框按行写文本(每行 = 一个片段)
批量输出
运行后产生一个任务目录(output/{tag}_{时间戳}/,或自定义 output_dir):
output/批量生成_20260807_120000/
├── 001_1.wav        片段 1 第 1 轮候选
├── 001_1.wav.seed   该轮种子(固定 seed 可复现)
├── 001_2.wav / 001_2.wav.seed
├── 001_3.wav / 001_3.wav.seed
├── 002_1.wav …      片段 2 的三轮候选
└── manifest.json    任务参数 + 每片段每轮的 seed/时长/验收标记
- 命名:
{片段序号:03d}_{轮次}.wav(001_1= 片段 1 第 1 轮) - 再次运行同一任务目录 = 断点续跑(已完成轮次跳过;参数变更则全量重跑)
节点参数
| 节点 | 参数 | 说明 |
|------|------|------|
| IndexTTSSingle | pause_mode | 开启 [pause:N] 精确停顿控制 |
| IndexTTSSingle | detect_cfm_steps | 已弃用(无作用),保留兼容旧工作流 |
| IndexTTSBatch | pause_mode | 批量开启;开启后自动跳过旧版后处理 |
| IndexTTSBatch | rounds | 每片段生成轮次(候选数) |
| IndexTTSBatch | interval_silence | 句号处停顿 ms(未写标记时,默认 400) |
| IndexTTSListen | task_dir | 接收批量节点的 task_dir 输出(连线优先) |
| IndexTTSListen | accept_round | 验收:0=仅试听;1/2/3=标记该轮通过(写入 manifest.json) |
| IndexTTSUnload | model | 释放模型显存(TTS 跑完、进视频流程前调用) |
| IndexTTSFix | marks | 停顿修复串:2:800, 3:0(序号:目标ms,0=删除)或 7.53:500(时间点:目标ms) |
| IndexTTSSrt | chosen | 定版选择:1,2,1,3(每片段轮次);单值 3=全部第 3 轮;空=全第 1 轮 |
建议的文本组织方式
- 分句稿一句一个片段;句号停顿默认统一(
interval_silence),个别要精确的写标记覆盖 - 句内停顿直接写
[pause:N] - 长句(>40 字)多标记时,个别标记可能因模型停顿波动未命中——换 seed 或从多轮候选中挑(rounds=3 通常有全命中的候选)
工作原理(简述)
想了解实现原理的看这里,日常使用不需要:
- 分句:文本按标点句切分(句号=分句边界;句内不切,保持语气连贯)
- 标记分类:句中标记 → 分句内处理;句号前/后标记 → 分句边界处理
- 分句内处理:标记转逗号 → 模型正常生成 → 用能量检测找出音频里的停顿(物理信号,不依赖识别模型)→ 把标记与停顿全局对齐(容忍模型多停/漏停)→ 只对停顿的"静音核心"做延长/缩短/插入(不碰语音,免重新解码)
- 分句边界处理:分句尾标记命中则跳过句间静音(防叠加),未命中则用句间静音补目标时长;最后一个分句未命中时在音频末尾追加静音
- 拼接:句间静音 =
interval_silence(默认 400ms),被标记覆盖的间隙用标记时长
术语:分句(segment)= 按标点切出的标点句(官方
split_sentences输出);片段 = 分句稿中的# 片段 N条目(一个片段可能含多个分句)。
详细方案、参数标定与精度数据见 docs/PAUSE_CONTROL.md;术语与代码符号对照、数据流见 docs/CODE_WALKTHROUGH.md。
已知限制
- 长单句多标记:标记位置按字符比例估算,长句(>40 字)误差可能超过匹配上限,个别标记可能未命中——换 seed 或从多轮候选中挑选即可覆盖
- 分句尾模型无停顿:会改用句间静音/末尾追加实现目标时长(时长仍达成),但停顿位置落在句号处而非标记字后——听感正确,位置略偏
- 长停顿后的换气声:模型自然韵律(长停顿后可能吸气),工具不处理呼吸声,介意可对该段做降噪后处理
- 插入需要真静音:语音连续处无法插入停顿(宁缺毋滥,不切字)
测试
test/ 提供三层测试:
python test/unit_test.py    # 核心函数单元测试(无需 GPU/模型,CI 自动跑)
python test/smoke_test.py --model-dir <模型目录> --spk-ref <参考音频>   # 中英双语冒烟
python test/regression_test.py --model-dir <模型目录> --spk-ref <参考音频>  # 5 片段回归
发布版实测:冒烟中英 PASS;回归 5 片段平均偏差 5ms。
致谢
- bilibili IndexTTS2 团队:模型与推理代码(本项目的
indextts/基于其开源实现修改) - ComfyUI:节点框架
- NVIDIA BigVGAN、Amphion MaskGCT:推理组件
- 序列比对算法:Needleman & Wunsch (1970)、Gotoh (1982)(详见 docs/PAUSE_CONTROL.md §8)
- 示例对比音频的参考音色来自第三方收集音色
致谢不代表上述团队对本项目的认可或背书;对原模型的修改与官方无关(见
THIRD_PARTY_NOTICES.md)。
License
- 本项目原创部分(ComfyUI 节点、pause 方案、文档):MIT License(见
LICENSE) indextts/推理代码:源自 bilibili IndexTTS2,受 bilibili Model Use LicenseAgreement 约束(商用需官方授权等),完整条款见LICENSE.bilibili.txt与THIRD_PARTY_NOTICES.md